記事公開日
リアルタイムデータ処理基盤の作り方―ストリーミング活用の実践手順

リアルタイムデータ処理基盤の作り方―ストリーミング活用の実践手順
【この記事の要約】
- リアルタイムデータ処理とは、データ発生から数秒〜数分で業務の判断につなげる方式です。表示の速さと鮮度は別問題です。
- 世界のIT部門リーダーの72%が、リアルタイム基盤の不足がAIの本格展開を妨げていると回答しています。
- 着手前に決めるべきは技術ではなく「許容遅延を何分に置くか」です。
⏱ 読了目安:約7分
1. リアルタイムデータ処理とは何か―鮮度と表示速度の違い
リアルタイムデータ処理とは、データが発生した時点から数秒〜数分以内に処理し、業務上の判断や動作につなげる方式です。一定期間分をまとめて定期実行するバッチ処理との違いは、処理速度ではなくデータの鮮度をどこまで業務に合わせるかという設計思想にあります。
混同されやすいのが「ダッシュボードの表示が速い」ことです。表示が一瞬でも、中身が前夜のバッチ集計なら鮮度は昨晩のままです。朝会で「この数字はいつ時点ですか」と聞かれ「昨晩23時までです」と答えた瞬間に議論が止まる。あるいは、すでに在庫が切れた商品がサイト上では在庫ありのまま数時間表示され続ける。よくある症状です。
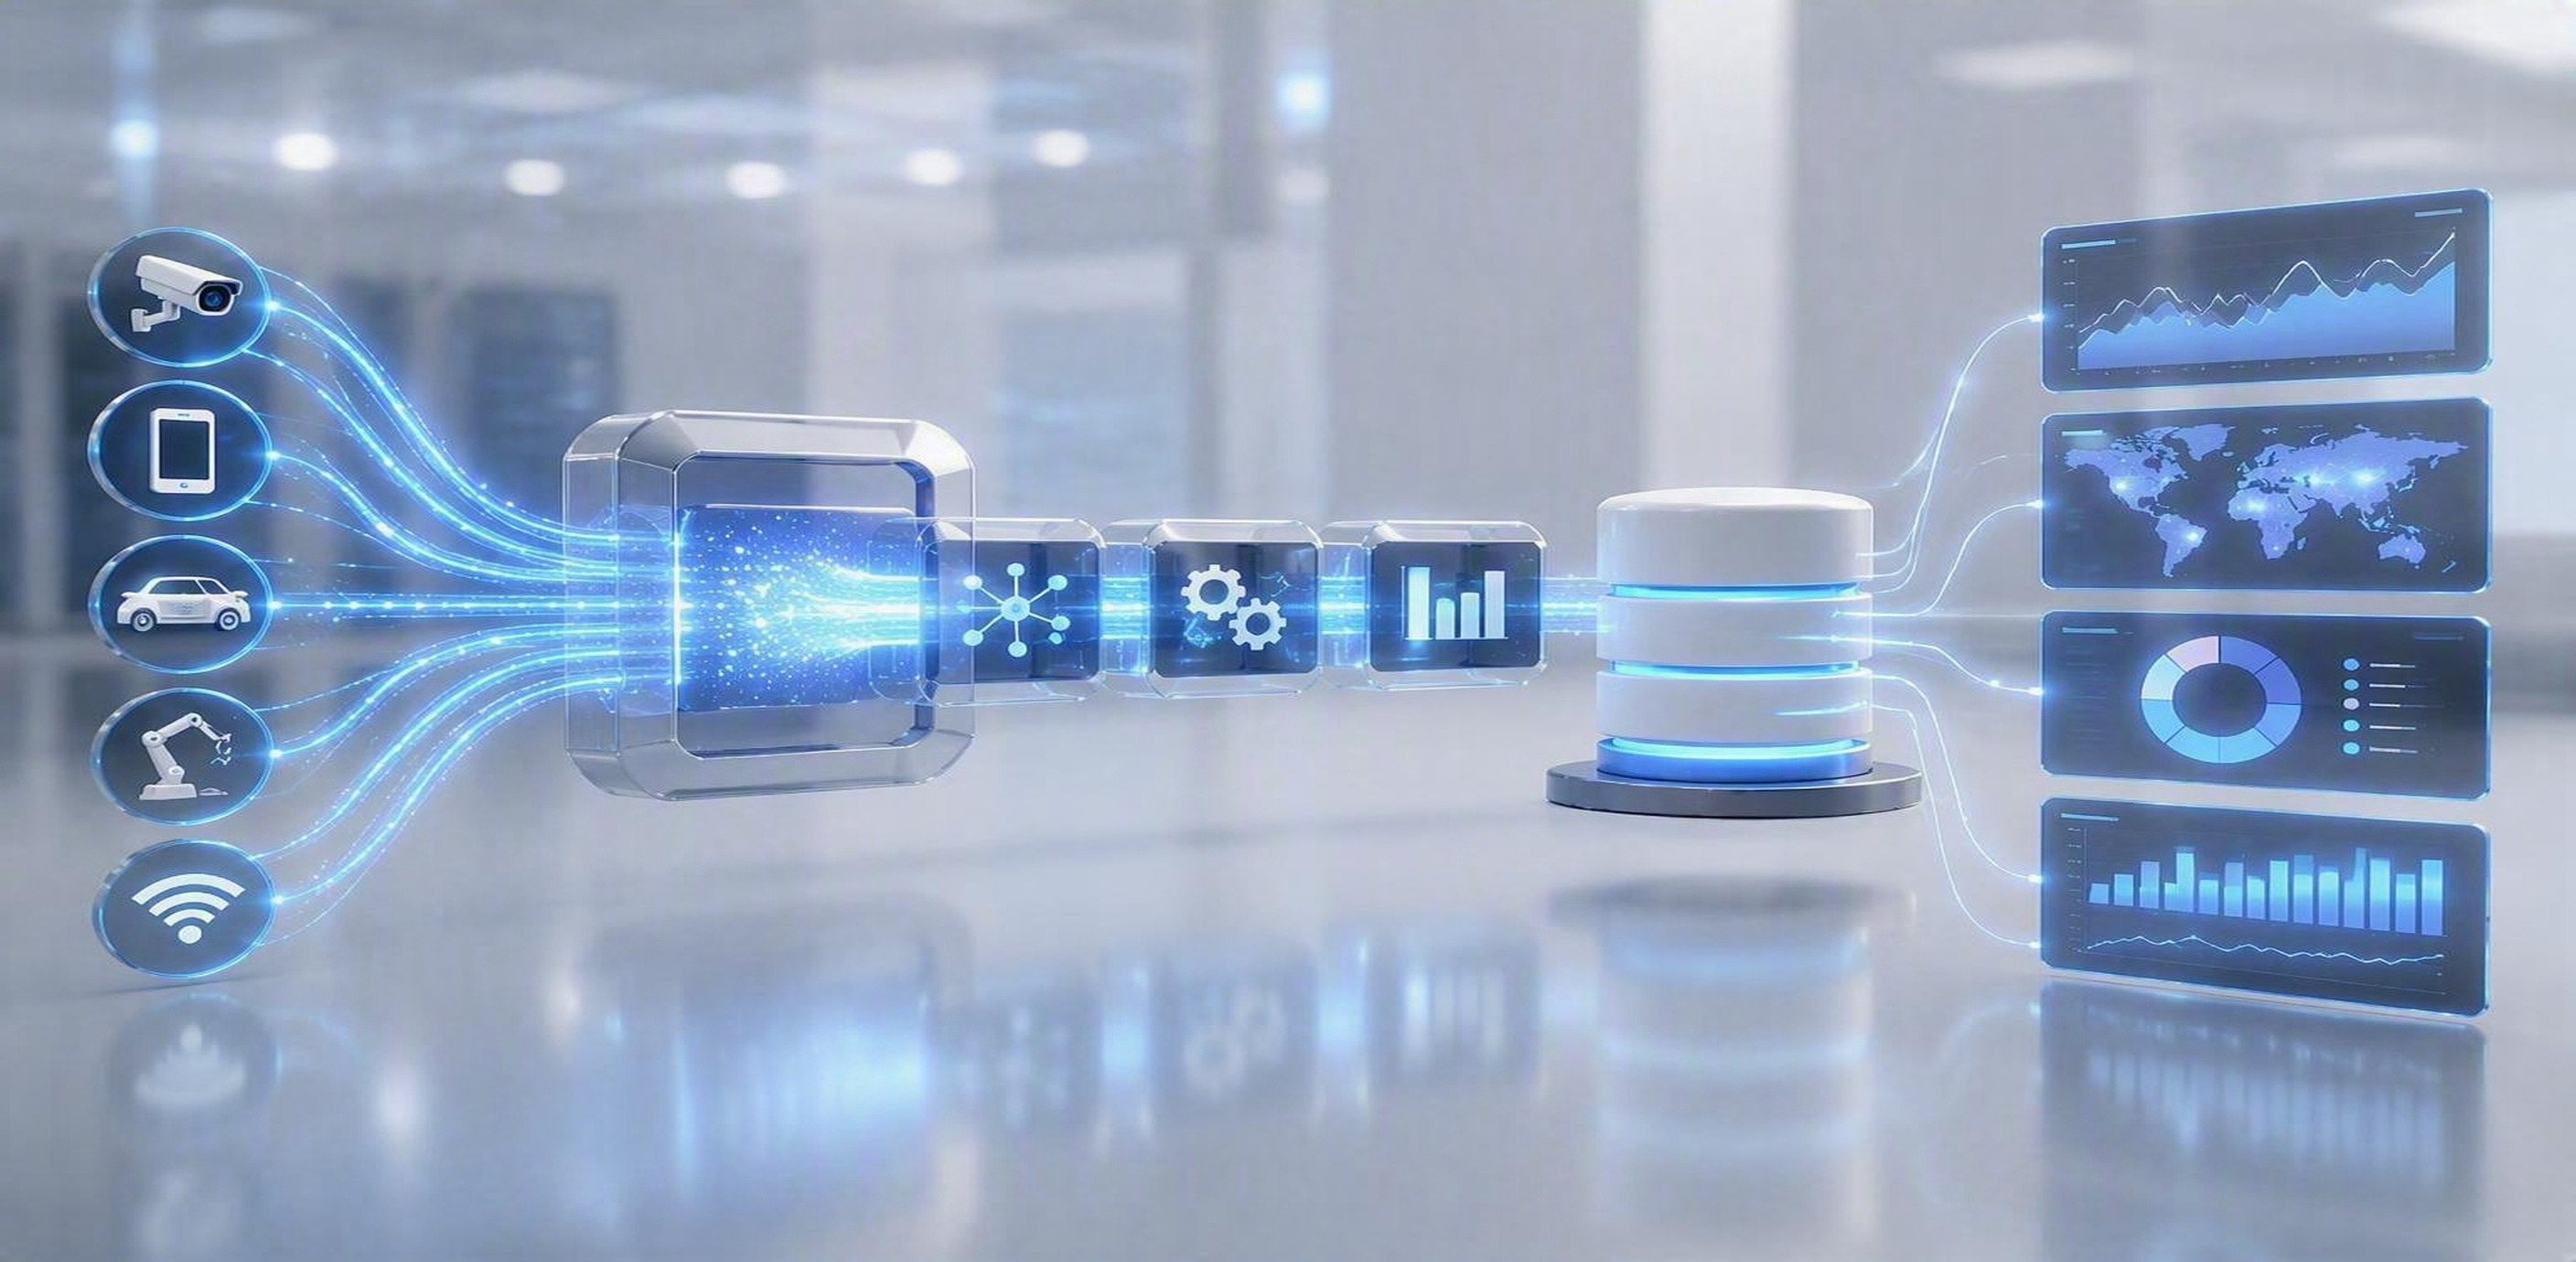
ストリーミング処理は、注文・クリック・センサー値といった個々のイベントを到着順に連続的に処理し続ける方式です。1日1回まとめて動かす発想から、常に流れている中に処理を置く発想への転換です。
2. なぜいま必要なのか―AI活用が露出させたバッチの限界
結論から言えば、AI活用の本格化がバッチ前提の基盤の限界を可視化したためです。
データストリーミング製品を手がけるConfluentが2026年6月16日に公表した「2026 Data Streaming Report」(世界14か国、従業員500人以上企業のIT部門リーダー4,625名対象)では、AIを本格展開する際の課題としてリアルタイムデータ処理のためのインフラが不十分(72%)が挙げられ、AIエージェントを本番稼働させている企業は32%にとどまりました(出典:Confluent「AI ambitions at risk」)。
国内も近い構図です。IPA(独立行政法人情報処理推進機構)が2026年7月16日に公表した「DX動向2026調査のポイント」(国内企業1,799社)では、AI導入は大企業を中心に広がる一方、活用は業務効率化・迅速化が中心で企業価値創出への展開は限定的だと整理されています(出典:IPAプレス発表)。
2つの調査を重ねると、次の構図が見えてきます。AIは「いま何が起きているか」を前提に判断しますが、バッチ前提の基盤では参照できる事実が常に数時間から1日前のものになる。効率化の域を超えないのは、モデルの性能ではなくデータが届く速度が制約になっている場合が少なくないのです。
3. 基盤の構成要素―5つのレイヤーで捉える
基盤は次の5レイヤーに分けると、設計の抜けが減ります。
| レイヤー | 役割 | 主な論点 |
|---|---|---|
| ①収集 | 業務システムやセンサーからイベントを取り出す | 既存DBの変更検知(CDC)/既存システム負荷 |
| ②転送・バッファ | イベントを一時保持し順序を保って渡す | 保持期間/どこまで巻き戻せるか |
| ③処理 | 集計・結合・判定を連続実行する | 集計の時間幅/遅れて届いたデータ |
| ④保存・提供 | 即時参照と分析用蓄積に分けて渡す | 参照用ストアと分析基盤の分担 |
| ⑤監視・運用 | 遅延・欠損・重複を検知し復旧させる | 遅延箇所の切り分け/一次対応の担当 |
最初につまずくのは③でも④でもなく⑤です。「数字が更新されていない」と連絡を受けてから、原因が収集側か処理側かの切り分けに1日を費やすという状況に陥りがちです。構築前に、各レイヤーの通過時刻を記録する設計を入れておきましょう。
4. 実践ステップ―4段階で小さく立ち上げる
全社データを一気にストリーミング化する進め方は、ほぼ途中で止まります。対象を絞って立ち上げましょう。
| ステップ | やること | 完了の目安 |
|---|---|---|
| 1. 用途を絞る | 遅れることで損をしている業務を1つ選ぶ | 失う金額・時間を1行で言える |
| 2. 許容遅延を決める | 「何分以内に反映されれば業務が成立するか」を業務部門と合意 | 「5分以内」等の数値が残る |
| 3. 最小構成で試す | 1系統のデータだけで収集〜提供まで通す | 業務部門が実データで判断できた |
| 4. 運用設計を固める | 遅延監視・再処理手順・一次対応の担当を決める | 障害時の手順書がある |
まず自問すべきは「本当に秒単位が必要か」です。5分間隔の短周期バッチ(マイクロバッチ)で足りる業務は相当あり、既存バッチの実行間隔を短くするだけで許容遅延を満たせるなら、無理に新基盤を建てる必要はありません。逆に不正検知や設備の異常停止のように数分の遅れが損失になる業務では、秒単位が要件になります。この線引きを先に済ませると技術選定が軽くなります。
5. よくある3つの失敗パターン
1. 許容遅延を決めないまま作り始める
「リアルタイムで見たい」をそのまま要件にすると、情報システム部門は数秒、業務部門は30分以内を想定していた、という食い違いが受入テストで表面化します。過剰な構成で作った基盤の運用費を、その後何年も払い続けることになります。
2. 障害時の再処理設計を後回しにする
ネットワークの一時断で同じイベントが2回届くと、売上の二重計上や同じ発注が2件飛ぶ事態が起きます。厄介なのは処理自体は正常終了しているためエラーとして検知されない点です。月次で突き合わせた担当者が差異に気づき、補正に数日を費やす。製品側に重複を防ぐ仕組みがあっても、外部システムへの書き込みまでは保証が及ばないことが多いため、イベントに一意のIDを持たせ受け取り側で重複を排除する設計を最初から入れましょう。
3. 技術選定から入る
製品比較表から始めると議論が「どの製品が優れているか」に流れ、用途が置き去りになります。基盤は動いているのに参照するのは月末の担当者1人だけ、という状態は珍しくありません。成果を説明できず、次年度の予算が付きません。
6. 業種別の活用イメージ
効果が出やすい業務には共通点があります。判断のタイミングが決まっており、遅れると選択肢が消える業務です。
- 小売・EC業:在庫と価格の即時反映。欠品商品の販売継続を止められれば、お詫び対応の工数が減ります。
- 製造業:稼働データからの異常兆候検知。停止後に動く運用と、兆候段階で保全計画に組み込む運用では停止時間が変わります。
- 金融・決済業:不正利用の検知。取引成立後に気づく仕組みでは被害回収と顧客対応が発生します。
- SaaS・サービス業:利用状況に応じた顧客フォロー。ログイン頻度の低下を月次で知るのと翌日に届くのでは打てる手が変わります。
逆に月次の予実管理のように判断サイクルが長い業務では、投資対効果は出にくくなります。
7. まとめ―「秒」の前に「許容遅延」を決める
リアルタイム基盤が行き詰まる原因は、たいてい技術以前にあります。「どの業務の、どの判断を、何分以内にしたいのか」が決まらないまま作ると、動いているのに使われない仕組みが残ります。
最初の一歩として、「データが届くのが遅くて損をしている場面」を3つ書き出し、許容遅延を分単位で書き添えることをおすすめします。この1枚で、リアルタイム化が必要な業務とバッチ間隔の短縮で済む業務を切り分けられます。
【本記事のまとめ】
- 要件は「速さ」ではなく「許容遅延を何分に置くか」で決まります。
- 収集・転送・処理・提供・監視の5レイヤーで設計し、監視と再処理から決めます。
- 5分間隔のマイクロバッチで足りる業務も少なくありません。用途を1つに絞って始めます。
データ活用に関するお悩みは、株式会社コネクトデータのデータ活用コンサルティングをご活用ください。貴社の課題に応じた進め方を無料でご相談いただけます。
8. よくある質問
- Q. リアルタイム基盤を作れば、バッチ処理は不要になりますか?
- A. 不要にはなりません。月次決算のように期間を締めてから集計する処理は、バッチのほうが正確かつ低コストです。即時性が必要な業務にストリーミング、締めが必要な業務にバッチを割り当てる併用が一般的です。既存バッチの廃止を前提に計画すると、移行時の検証負荷が跳ね上がります。
- Q. 小規模から始められますか。費用が膨らむ要因は何ですか?
- A. 1系統のデータに絞れば、クラウドのマネージドサービスで小さく始められます。費用はデータ量と保持期間に左右されるため一律には言えませんが、膨らむ主因は「全システムのデータを念のため流し、長期間保持する」設計です。対象を1業務・1系統に限定し、必要に応じて広げてください。
- Q. 自社で内製できますか。必要なスキルは何ですか?
- A. 設計と運用の一部は内製できます。求められるのは、イベント設計(何を1件のイベントとするか)、時間幅を意識した集計の理解、遅延・重複を前提とした障害対応の設計です。初期構築のみ外部に委ねる場合は、監視項目と再処理手順を引き渡し時点で必ず文書化してください。曖昧だと、障害のたびに外部へ問い合わせる運用が固定化します。