記事公開日
AIエージェントに渡すデータの権限設計―「見せてよい範囲」をどう決めるか
【この記事の要約】
- AIエージェントの権限は、管理者など強い権限を流用せず、担当業務に必要な最小限に絞るのが基本です。
- 見せてよい範囲は「データの機微性」と「エージェントの自律性」の2軸で判断します。
- 全データの分類は不要。参照のみ・機微性が低〜中の領域から始めて広げます。
⏱ 読了目安:約8分
1. AIエージェントのデータ権限設計とは何か
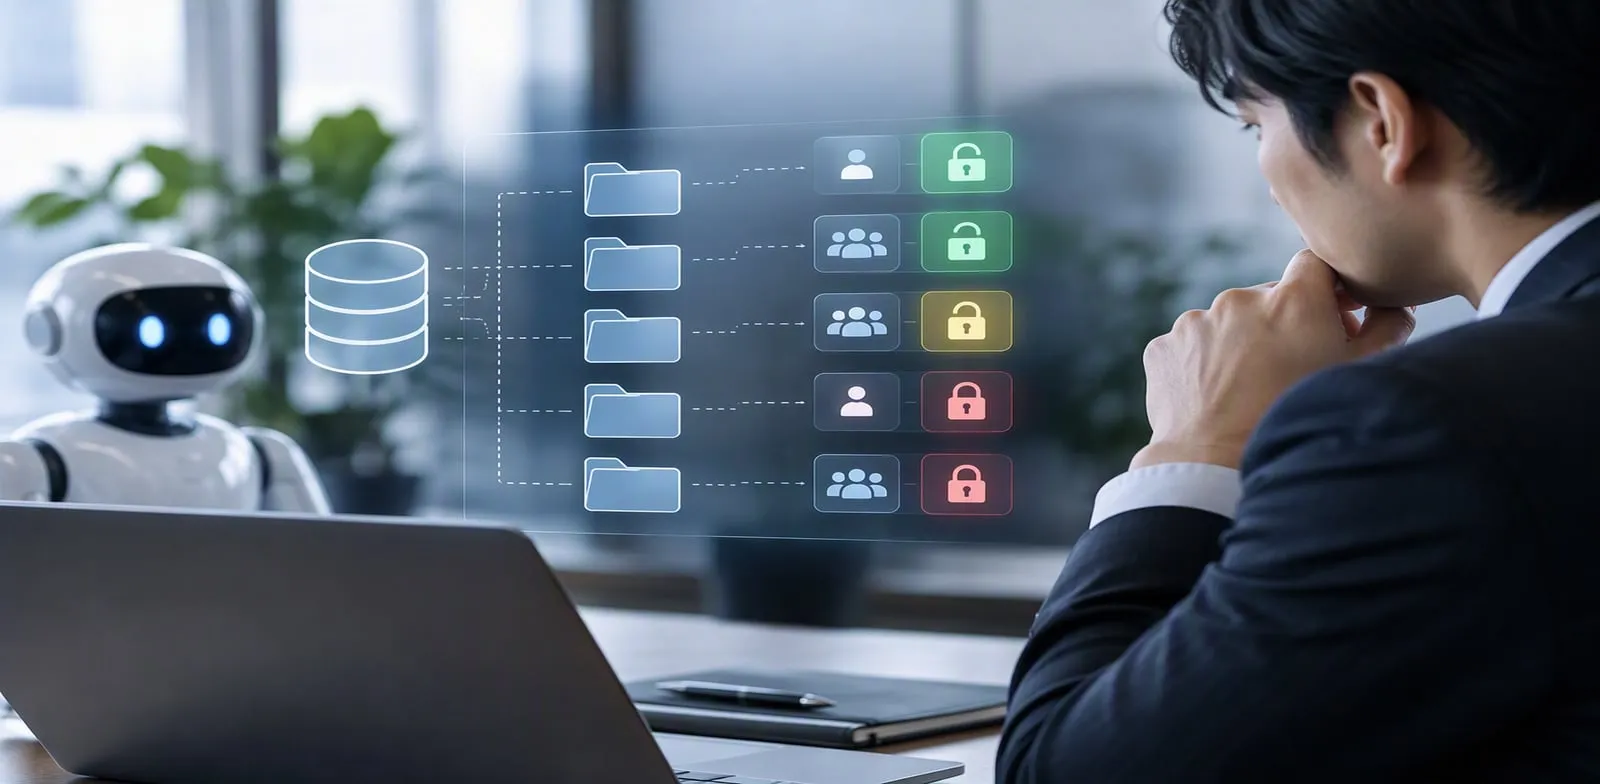
結論:権限設計とは、エージェントに「何を見せ、何をさせるか」を、担当業務に必要な最小限に絞って決めておくことです。管理者など強い権限を持つ人のIDを、そのままエージェントに使わせることではありません。依頼した利用者の権限の範囲に収めたうえで、エージェント自身にも最小限の権限を設定する、という考え方です。
ここでいうAIエージェントは、質問に答えるだけでなく、社内システムのデータを検索・参照し、場合によっては更新や送信まで行うAIの仕組みを指します。人は「見てはいけないものは見ない」と自制できますが、エージェントは与えられた権限の範囲なら何でも読みにいきます。そして、読んだ内容を本来の相手以外に答えてしまう危険も、権限の外に出す操作を誤って実行してしまう危険も、渡した権限の大きさがそのまま被害の大きさになります。
想定される光景はこうです。人事部門の問い合わせ用に作ったエージェントが、全社共有フォルダの読み取り権限を持っていたため、一般社員の質問に対して、本来は人事部門しか見られない評価資料の内容を引用して答えてしまう。誰かが悪意を持ったわけではなく、権限が広すぎただけで起きます。OWASP Gen AI Security Projectの「LLM06 Excessive Agency」は、この種の問題の根本原因を、過剰な機能・過剰な権限・過剰な自律性の3つに整理しています。
Gartnerは2026年9月30日の発表で、AIエージェントのアクセス管理はモデルの賢さではなく、そのエージェントが実行できる操作権限を基準に統制すべきだとしています。同じ発表には、Gartnerが2026年第2四半期に297名のサイバーセキュリティリーダーに行った調査で、AIエージェントのアクセスを制限する明確な方法がない、または事前定義された人間のアクセス権に頼っている組織が54%だったとあります。権限設計は、まだ多くの組織で手つかずの領域だと読めます。
2. 「見せてよい範囲」を決める2つの軸:機微性と自律性
結論:見せてよい範囲は、「データの機微性」と「エージェントの自律性」の2軸で決めると、議論が迷子になりません。
Gartnerは2026年9月30日掲載の記事で、AIエージェントのリスク対策の優先順位を、エージェントがアクセスできるデータの機微性と、自律性(どこまで自動で動くか)の2点で決めることを勧めています。あわせて、各エージェントの権限とスコープを文書化し、ビジネスリスクごとに分類することも推奨しています。この考え方を、社内向けエージェントの権限設計に当てはめた判断基準表が次のとおりです。
| 自律性 \ データの機微性 | 低(公開・社内一般) | 中(部門内・取引情報) | 高(個人データ・経営機密) |
|---|---|---|---|
| 参照のみ(答えを返すだけ) | 広く許可してよい | 利用者本人の権限の範囲に限る | 原則対象外。使う場合は対象者と用途を限定 |
| 提案(下書き・推奨を作る) | 許可してよい | 人が確認してから使う | 個別に設計し、承認者を決める |
| 実行(更新・送信まで行う) | 影響の小さい操作に限り許可 | 実行前に人の承認を挟む | 当面は実行させない |
まず自問すべきは「このエージェントは、間違った答えを返したら困るのか、間違った操作をしたら困るのか」です。前者なら左上の領域から始められ、後者なら人の承認が必要です。表の右下に近づくほど、設計・承認・ログの手間が増えます。
3. データ分類の作り方と、企業固有データの扱い
結論:データ分類は細かくしすぎず、4区分程度から始め、区分ごとに「エージェントに渡してよいか」を先に決めておきます。
区分の例と、データ項目の具体例を次の表に示します。
| 区分 | データ項目の例 | エージェントへの渡し方の例 |
|---|---|---|
| 公開・社内一般 | 製品カタログ、社内規程、FAQ、手順書の最新版 | 広く参照を許可する |
| 部門内 | 部門の売上明細、取引先ごとの見積、案件の議事録 | 利用者の所属・役割に応じて参照を絞る |
| 限定(個人データ) | 従業員の氏名・住所、顧客の連絡先、問い合わせ履歴の個人情報 | 対象業務と対象者を限定し、マスキングを検討する |
| 厳秘 | 経営会議資料、未公開の財務情報、人事評価 | 当面は対象外とし、必要なら別枠で設計する |
ここで押さえたいのは、企業固有のデータこそ、エージェントを他社と差別化する源泉である一方、守るべき資産でもあるという点です。PwC Japanグループは2026年6月の資料で、汎用モデルへの依存はアウトプットの均質化を招き、企業固有のナレッジをAIに入力することが必須だと提言しています。固有データを活かすには、AIが使える形に整えるだけでなく、「どのデータを誰の業務のために開くか」を決めることが欠かせません。区分や所有者、見せてよい範囲といった意味付け(メタデータ)が文書に付いていなければ、エージェントは見せてよいかどうかを判断できず、権限の設計も機械的にしか行えません。
4. 権限設計を進める4ステップ
結論:業務の特定、データの分類、権限の決定、承認・ログ・見直しの順に進めます。
| 1.業務を決める 任せる範囲を明確に | ▶ | 2.データを分類 触れるデータを一覧化 | ▶ | 3.権限を決める 誰の権限で動かすか | ▶ | 4.承認と記録 承認・ログ・見直し |
1. 業務を決める:「経理の問い合わせ対応」のように、エージェントに任せる業務を1つに絞ります。「何でも答える」エージェントは、何でも見られる権限を求めます。
2. データを分類する:その業務が参照する文書・テーブル・システムを書き出し、前章の区分を当てはめます。書き出して初めて、想定外のフォルダが含まれていると気づくことも少なくありません。
3. 権限を決める:最大の論点は「誰の権限で動かすか」です。方式は大きく2つあります。利用者本人の権限を引き継がせる方式と、エージェント専用のIDに最小限の権限を与える方式です。管理者など強い権限のIDを流用するのは避けます。利用者の権限を引き継ぐ場合も、エージェント側で使える機能とデータを絞り、両方で許可された範囲だけを使えるようにする設計が考えやすいでしょう。OWASPは前掲ページで、拡張機能の数・機能・下流システムへの権限を最小限に絞ること、操作を利用者の文脈で行わせること、そして権限の判断をモデルに任せず下流のシステム側で確認することを緩和策に挙げています。Snowflakeも2025年11月6日の公式ブログで、自社製品のエージェント機能について、利用者のIDとロールを引き継ぎ、データに設定された保護ポリシーに従うと説明しています。自社の環境でこの方式が使えるかは、利用中のデータ基盤やツールの仕様で確認します。
4. 承認と記録を決める:メール送信や更新など影響の大きい操作は、人の承認を挟みます。あわせて、誰の依頼で、どのデータを参照したかのログを残し、定期的に見直す担当者を決めます。社内規程との関係は、当社コラムAI・データ利活用における社内規程整備の進め方、利用ルールの作り方は生成AI活用における社内ガバナンス・利用ポリシーの作り方もご覧ください。
5. 全部は設計しきれないときの代替ライン
結論:最初から全社のデータを分類する必要はありません。「参照のみ」「機微性が低〜中」の領域に絞って始めるのが、現実的な進め方です。
分類の作業が追いつかない場合の最低ラインは次の3つです。第一に、エージェントの参照先を、分類済みの特定のフォルダやテーブルだけに限定する(それ以外は見えない状態にする)。第二に、個人データや厳秘の文書が混ざりうる場所は、一覧化できるまで対象から外す。第三に、実行権限は付けず、参照と下書きから始める。これだけでも、過剰な権限による事故のリスクを抑える助けになります。ただし、範囲を広げる段階では、改めて分類と権限の見直しが必要です。
Gartnerの前掲記事は、機微性と自律性の2点でリスクの優先順位をつけることを勧めています。この考え方に沿えば、リスクの高い領域から順に設計を進められます。専用の統制ツールの導入は、手作業の運用で限界が見えてから検討する進め方もあります。
6. よくある失敗パターンと想定される損失
人間の管理者の権限をそのまま使うパターン
想定例として、導入を急ぎ、情シス担当の強い権限でエージェントを動かすケースです。誰の質問にも、全社の文書を根拠に答えられる状態になり、後から参照範囲を絞る作業に、情シス担当が相当な工数を割くことになりかねません。その間、エージェントの利用を止めざるをえない場合もあります。
共有フォルダを丸ごと読ませるパターン
想定例として、フォルダ単位で読み込ませたところ、一部のファイルに、本来は閲覧が限られていた資料が混ざっていたケースです。元のファイルに付いていた閲覧制限が、読み込み後の検索では効かなくなる設計の場合、気づくのは事故が起きてからです。対象部門への説明、削除、再読み込みで、関係者の工数が失われます。
承認の担当者が決まっていないパターン
想定例として、「人の承認を挟む」と決めただけで担当者を定めなかったため、承認待ちが溜まり、現場が承認を省略する運用に流れるケースです。人の承認が形だけになり、統制の意味が失われます。
7. 活用イメージ:経理の問い合わせ対応エージェントの場合
例えば(想定例)、経理部門の「経費精算・請求書の問い合わせ」に絞ってエージェントを作る場合を考えます。参照先は、経費規程・精算手順書・FAQなど「公開・社内一般」の文書に限り、自律性は「参照のみ」から始めます。個々の従業員の精算履歴を答えさせたい場合は、利用者本人の権限を引き継ぐ方式を検討し、本人の分しか見えない設計にします。支払処理の実行は、当面、人が行います。エージェント全体の導入の考え方は、当社コラムAIエージェントは業務をどう変えるかもご覧ください。
8. まとめ:最初の一歩は「エージェントが触るデータ」を1枚の表に書き出すこと
権限設計は、機微性と自律性の2軸で「見せてよい範囲」を決め、最小限の権限から始めるのが基本です。まずは、任せたい業務を1つ選び、そのエージェントが参照するデータを「データ項目・区分・参照してよい人・実行の有無」の4列で1枚の表に書き出してください。空欄が残る行は、まだ渡してはいけないデータです。
【本記事のまとめ】
- 管理者など強い権限を流用せず、担当業務に必要な最小限に絞る
- データの機微性とエージェントの自律性の2軸で、見せてよい範囲を判断する
- 全データは分類しきれない。参照のみ・機微性が低〜中の領域から始める
AIエージェントに渡すデータの分類や権限の設計、ガバナンス体制づくりでお悩みの方は、株式会社コネクトデータのデータ活用コンサルティングで、現状整理から設計までご相談いただけます。
9. よくある質問
- Q. 利用者本人の権限を引き継ぐ方式と、専用IDで動かす方式は、どちらがよいですか?
- A. 問い合わせ対応のように、利用者ごとに見てよい範囲が違う業務は、本人の権限を引き継ぐ方式が向いています。夜間バッチのように利用者がいない定型処理は、専用IDに最小限の権限を与える方式が現実的です。自社の基盤が前者に対応しているかは、利用中のツールの仕様で確認してください。
- Q. 個人情報を含むデータは、エージェントに渡してはいけませんか?
- A. 一律に禁止する必要はありませんが、最初は対象から外して始めるのが安全です。渡す場合は、対象の業務と対象者を限定し、マスキングの可否と、閲覧できる人の範囲、ログの保管方法を先に決めてください。
- Q. 権限の設計は、誰が担当すればよいですか?
- A. データの持ち主である業務部門が「見せてよい範囲」を決め、情シスやセキュリティ担当が仕組みで実現する分担が現実的です。決める人が曖昧なままだと、導入時に広い権限が付いたまま運用が続きます。